
Le scénario est devenu assez banal
Vous prenez une demande reçue par mail, vous la donnez à un outil d’intelligence artificielle, et quelques secondes plus tard vous obtenez une réponse bien rédigée. L’outil a compris la demande, retrouvé les éléments utiles dans un document et préparé un message convaincant.
La démonstration fonctionne. Tout le monde se regarde avec le petit sourire de ceux qui viennent d’économiser beaucoup de temps.
Puis arrive la phrase qui m’inquiète toujours un peu : « On pourrait automatiser tout ça. »
Peut-être. Mais entre préparer une réponse et l’envoyer automatiquement, il existe une différence considérable. Entre repérer une incohérence dans un dossier et modifier directement ce dossier, également. Entre suggérer une décision et la prendre, je vous laisse imaginer.
Tant que l’IA reste dans une fenêtre de conversation, ses erreurs restent généralement dans cette fenêtre. Dès qu’on lui donne accès à une messagerie, un agenda, un logiciel métier ou une base de données, ses erreurs peuvent produire des effets dans le monde réel.
Le sujet mérite donc mieux qu’une démonstration réussie et un enthousiasme collectif autour d’une table. Il demande une méthode.
Un métier ne s’automatise pas d’un bloc
Quand une entreprise commence à s’intéresser sérieusement à l’IA, la discussion porte souvent sur les métiers : peut-on automatiser le service client ? La comptabilité ? Les ressources humaines ? La communication ?
Ce niveau d’analyse est trop large pour décider quoi que ce soit.
Prenons le traitement d’une réclamation client. Derrière cette expression se cachent plusieurs tâches : recevoir le message, identifier le client, retrouver sa commande, comprendre le problème, vérifier les conditions applicables, choisir une réponse, la rédiger, éventuellement proposer un geste commercial, envoyer le message et mettre à jour le dossier.
Ces tâches n’ont ni la même difficulté, ni les mêmes conséquences.
Retrouver une référence de commande peut être largement automatisé. Résumer les échanges précédents aussi. Préparer une réponse est souvent un très bon usage de l’IA. Décider d’un remboursement et envoyer le message sans validation posent d’autres questions.
Les premières études sur les usages réels de l’IA confirment cette logique. L’Anthropic Economic Index, construit à partir d’environ un million de conversations anonymisées avec Claude, montre que l’IA est utilisée de manière sélective à l’intérieur des métiers. Environ 36 % des professions observées l’utilisent pour au moins un quart de leurs tâches, mais seulement 4 % pour les trois quarts. L’assistance au travail humain reste plus fréquente que l’automatisation complète, à 57 % contre 43 %.[1]
36 %
des professions utilisent l’IA pour au moins un quart de leurs tâches
4 %
seulement pour les trois quarts de leurs tâches
57 / 43
assistance au travail humain contre automatisation complète
Autrement dit, les organisations n’automatisent pas des métiers entiers. Elles confient à l’IA certains morceaux du travail.
C’est beaucoup moins spectaculaire dans une présentation PowerPoint. C’est aussi beaucoup plus utile pour prendre de bonnes décisions.
Ce que les anciennes automatisations nous ont déjà appris
L’idée d’automatiser des tâches de bureau n’est pas née avec ChatGPT. Depuis des années, des « robots logiciels » reproduisent des manipulations simples : ouvrir un fichier, copier une donnée, remplir un formulaire, rapprocher deux tableaux ou déposer un document dans le bon dossier.
Les spécialistes de cette automatisation ont appris à repérer les bons candidats. Ils privilégient les processus fréquents, relativement stables, standardisés, alimentés par des données bien organisées et comportant peu d’exceptions.[2]
La logique est facile à comprendre. Si une tâche revient mille fois par mois et suit presque toujours le même chemin, le temps investi pour l’automatiser peut être rapidement récupéré. Si elle change toutes les semaines et comporte vingt cas particuliers, la machine risque de coûter plus cher à maintenir que le travail qu’elle remplace.
L’IA générative déplace légèrement cette frontière. Elle sait travailler avec du texte libre, interpréter une demande formulée de plusieurs façons et traiter des documents qui ne suivent pas tous exactement le même modèle. Des tâches autrefois trop variables deviennent donc accessibles.
Cette souplesse a un prix : le résultat n’est pas parfaitement prévisible. Un programme classique applique les règles qu’on lui a données. Une IA générative produit une réponse probable à partir de ce qu’elle a compris du contexte. Elle peut faire quelque chose de remarquable à 9 h 02 et se tromper sur un cas presque identique à 9 h 04. C’est agaçant mais c’est une réalité.
Il faut donc conserver les enseignements de l’automatisation classique tout en ajoutant des critères liés aux données, aux conséquences d’une erreur et à la reprise en main par une personne.
La grille des six questions, un outil de la méthode Triple A de Qoléo
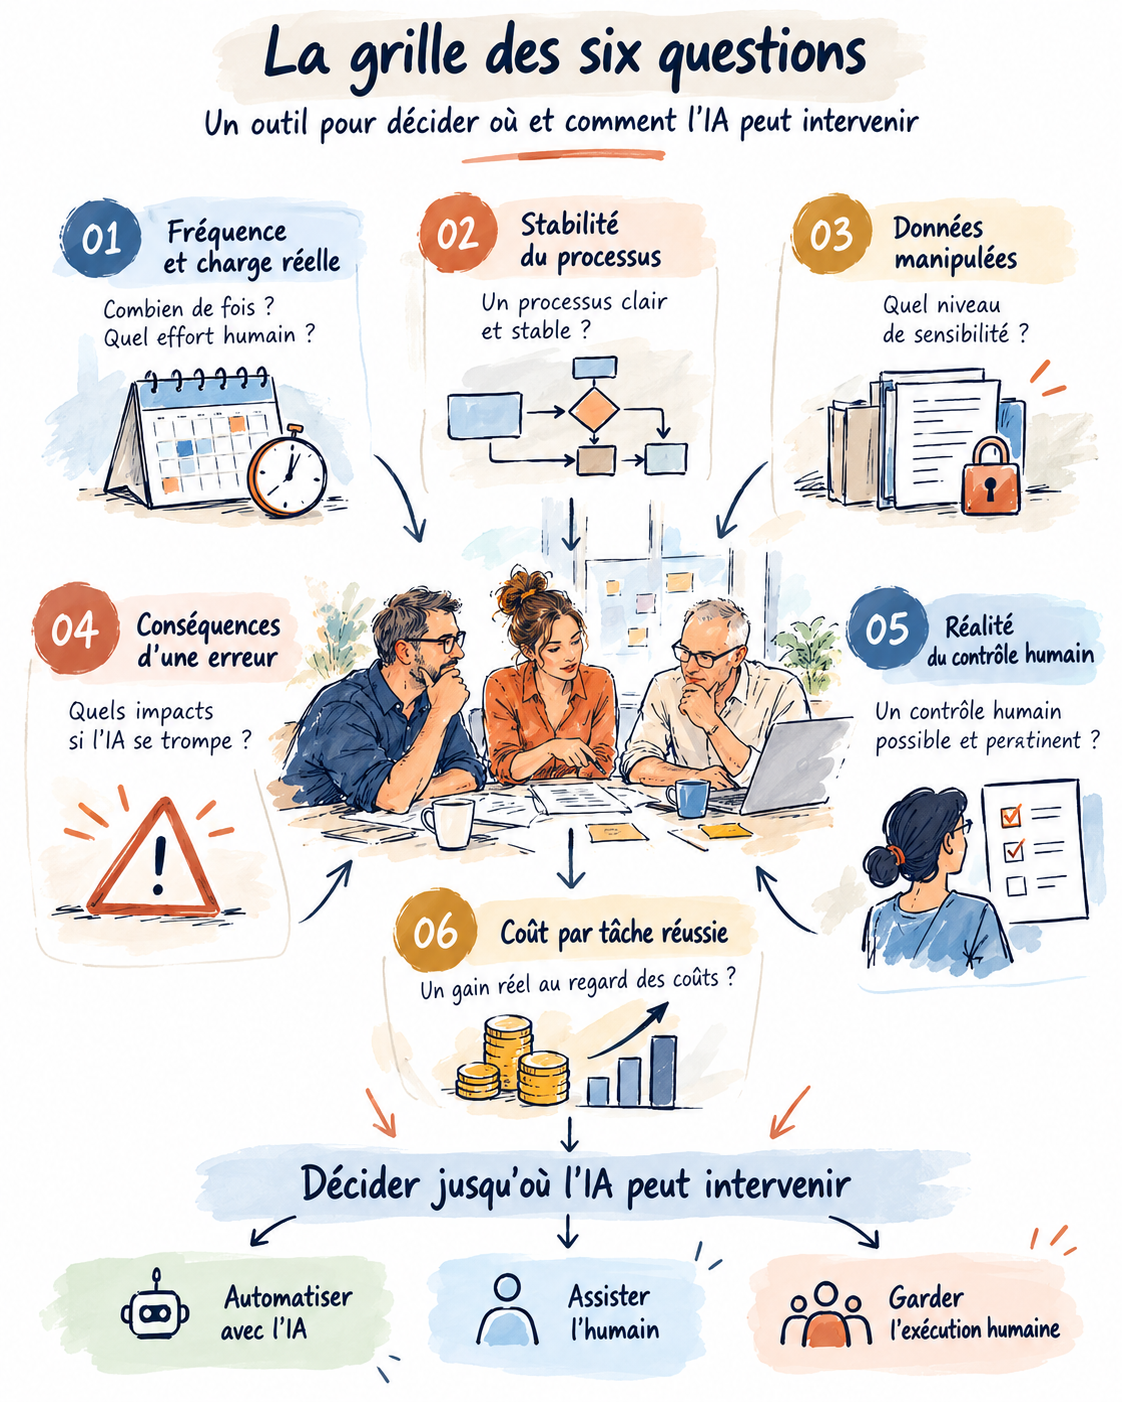
Chez Qoléo nous utilisons pour cela une grille en six questions.
Elle ne délivre pas un permis automatique ou une interdiction définitive. Elle aide à choisir jusqu’où l’IA peut intervenir dans un processus.
01À quelle fréquence cette tâche revient-elle ?
La fréquence est le point de départ le plus évident. Une tâche réalisée cinquante fois par jour semble plus intéressante à automatiser qu’une tâche annuelle.
Encore faut-il mesurer la réalité.
Une action peut revenir souvent tout en ne prenant que quelques secondes. Une autre peut être rare mais monopoliser deux personnes pendant plusieurs jours. Il faut donc regarder à la fois le nombre d’occurrences, le temps passé et la concentration éventuelle de la charge sur certaines périodes.
Une opération mensuelle de contrôle peut sembler secondaire sur l’année. Si elle bloque l’équipe pendant trois jours à chaque clôture, l’enjeu devient très concret. À l’inverse, automatiser une manipulation quotidienne de trente secondes risque de ne jamais rembourser le temps consacré à sa conception, à ses tests et à sa maintenance.
La répétition n’est pas non plus obligatoire. Certaines campagnes ponctuelles justifient une automatisation légère : reprendre plusieurs milliers de lignes, classer un stock de documents ou préparer une migration. Des travaux consacrés à la robotisation des processus montrent justement que des usages temporaires ou des prototypes peuvent être pertinents, même lorsqu’ils sortent des critères habituels.[2]
La bonne question est donc plus précise que « cette tâche revient-elle souvent ? »
Combien d’effort humain représente-t-elle réellement, à quelle période, et pendant combien de temps continuera-t-elle d’exister ?
02Le processus est-il suffisamment stable ?
Il existe une tentation assez répandue : utiliser l’IA pour remettre de l’ordre dans un processus que personne ne maîtrise vraiment.
C’est rarement une bonne première étape.
Si deux personnes ne réalisent pas la même tâche de la même façon, si les règles changent selon l’interlocuteur ou si personne ne sait expliquer pourquoi certains dossiers prennent un chemin différent, l’automatisation risque de figer le désordre. Elle le fera simplement plus vite.
Évaluer la stabilité d’un processus ne demande pas une modélisation compliquée. On peut commencer par quelques questions simples.
- Existe-t-il un chemin habituel ?
- Les informations nécessaires sont-elles disponibles au même endroit ?
- Combien de cas sortent de la procédure normale ?
- Que fait-on lorsqu’une information manque ?
- Les règles ont-elles changé au cours des six derniers mois ?
Le taux d’exceptions est souvent plus instructif que la description officielle du processus. Sur le papier, tout est généralement propre. Dans la vie réelle, il y a le client historique, le dossier incomplet, la règle connue d’une seule personne et le fichier Excel dont personne n’ose demander l’origine.
Un processus instable n’est pas forcément exclu de tout usage de l’IA. Il peut très bien bénéficier d’une assistance : retrouver les informations, résumer le dossier, signaler les pièces manquantes ou préparer plusieurs options. En revanche, lui donner immédiatement une autonomie complète serait hasardeux.
L’IA peut aider à exécuter un processus imparfait. Elle ne remplace pas le travail consistant à comprendre ce processus.
03Quelles données l’IA va-t-elle manipuler ?
Cette question arrive encore trop tard dans beaucoup de projets.
On découvre l’usage, on s’enthousiasme pour le gain de temps, puis quelqu’un demande où partent les données. Petit silence dans la salle.
Toutes les informations n’ont pas la même sensibilité. Un catalogue public, une procédure interne, un contrat, un dossier médical ou les coordonnées personnelles d’un client ne peuvent pas être traités avec les mêmes précautions.
Il faut regarder les données qui entrent dans le système, celles qu’il va rechercher, celles qu’il produit et celles qu’il conserve éventuellement. Il faut aussi savoir qui peut y accéder, dans quel pays elles sont traitées et si elles servent à améliorer le service utilisé.
Je ne dis pas qu’une donnée sensible interdit automatiquement l’usage de l’IA. Je dis qu’elle augmente les exigences : choix de l’outil, paramétrage, limitation des accès, durée de conservation, traçabilité et contrôle.
Le NIST, l’organisme américain qui a publié un cadre de gestion des risques liés à l’IA, recommande d’accorder une attention plus forte aux systèmes entraînés ou utilisés avec des données sensibles, ainsi qu’aux systèmes dont les résultats peuvent affecter directement des personnes.[3]
Concrètement, un agent chargé de synthétiser des documents publics n’appelle pas les mêmes précautions qu’un agent autorisé à consulter les dossiers individuels des salariés.
Avant de parler de performance, il faut donc être capable de tracer le trajet de l’information. Si personne ne sait exactement quelles données sont utilisées et où elles circulent, le processus n’est pas prêt.
04Que se passe-t-il lorsque l’IA se trompe ?
Aucun système n’est infaillible. Aucun humain non plus, d’ailleurs. La comparaison pertinente porte sur les erreurs probables, leur détection et leurs conséquences.
Une mauvaise proposition de classement peut être corrigée en quelques secondes. Un message inadapté envoyé à cinq mille clients laisse davantage de traces. Une réservation supprimée par erreur peut parfois être recréée, mais la chambre a peut-être été vendue entre-temps. Techniquement, l’action était réversible. Commercialement, beaucoup moins.
Nous évaluons donc deux choses : la possibilité de revenir en arrière et le nombre de personnes ou de systèmes touchés avant la correction.
Un système en lecture seule présente naturellement moins de risques qu’un système autorisé à écrire dans les logiciels. Parmi les actions d’écriture, enregistrer un brouillon n’a pas la même portée qu’envoyer un message, publier un contenu, déclencher un paiement ou modifier les droits d’un utilisateur.
Cette distinction permet de progresser sans choisir entre immobilisme et autonomie totale.
On peut commencer par laisser l’IA observer et préparer. On peut ensuite l’autoriser à enregistrer certaines propositions sans les appliquer. Puis, si les résultats sont fiables, lui ouvrir quelques actions réversibles dans un périmètre limité.
- Lecture seuleObserver et préparer
- BrouillonEnregistrer sans appliquer
- Action réversibleDans un périmètre limité
- Action engageanteEnvoyer, publier, payer
Cette progression paraît moins impressionnante qu’un agent lancé en autonomie devant un public. Elle évite surtout de transformer les utilisateurs et les clients en participants involontaires à une expérimentation.
05Le contrôle humain est-il réel ?
« Il y aura toujours un humain dans la boucle. »
Cette phrase rassure beaucoup de monde. Elle ne garantit pourtant presque rien.
Pour qu’un contrôle humain soit utile, la personne doit disposer du temps nécessaire, comprendre ce qu’elle vérifie, avoir accès aux informations d’origine et pouvoir arrêter ou corriger le système. Si elle doit valider deux cents décisions par heure, son rôle risque de se résumer à cliquer sur un bouton.
Il faut également tenir compte d’un comportement très humain : plus un système donne souvent de bonnes réponses, moins nous contrôlons attentivement les suivantes. Le règlement européen sur l’intelligence artificielle parle de « biais d’automatisation », cette tendance à accorder une confiance excessive à la sortie produite par une machine.[4]
Pour les systèmes considérés comme à haut risque, le règlement demande notamment que les personnes chargées du contrôle puissent comprendre les capacités et les limites de l’outil, détecter les anomalies, ignorer ou inverser une sortie et interrompre le système dans un état sûr.[4]
Toutes les entreprises ne déploient pas des systèmes juridiquement classés à haut risque. Mais la logique est bonne pour tout le monde.
- Qui contrôle ? À quel moment ?
- Avec quelles informations ? Selon quels critères ?
- Que se passe-t-il en cas de doute ?
- Cette personne a-t-elle réellement l’autorité pour arrêter le système ?
Si les réponses restent floues, « l’humain dans la boucle » est une formule décorative.
06Quel est le coût d’une tâche réellement réussie ?
Les fournisseurs d’IA affichent souvent un coût par requête, par utilisateur ou par volume de texte traité. Ces chiffres sont utiles pour comparer des offres. Ils ne donnent pas le coût réel de l’automatisation.
Il faut ajouter le temps de conception, la connexion aux logiciels, la préparation des données, les tests, la supervision, la correction des erreurs et la maintenance. Un changement dans une interface ou une procédure peut obliger à reprendre une partie du dispositif.
Il faut aussi compter le temps humain qui reste nécessaire. Si l’IA prépare une réponse en dix secondes mais demande cinq minutes de vérification, le gain sera différent de celui annoncé pendant la démonstration.
Nous préférons donc calculer un coût par tâche réussie.
Définition
Une tâche réussie répond aux critères de qualité attendus, n’a pas créé de problème en aval et a nécessité un niveau de contrôle compatible avec l’économie recherchée.
Cette mesure oblige à intégrer les échecs au lieu de les cacher dans une moyenne flatteuse.
Le NIST recommande d’ailleurs d’examiner les bénéfices attendus, mais aussi les coûts monétaires et non monétaires liés aux erreurs et au fonctionnement du système.[3]
Cette approche évite une confusion fréquente entre vitesse et performance. Produire dix fois plus vite un résultat qu’il faut ensuite reprendre ne constitue pas nécessairement un progrès.
Une grille ne doit pas tout ramener à un score
À ce stade, la tentation consiste à noter chaque critère sur cinq, à additionner les points et à fixer une barre d’admission à l’automatisation.
Je comprends l’intérêt. J’aime aussi les grilles bien propres (personne n’est parfait). Mais certains risques ne devraient pas être compensés par un bon résultat économique.
Une fréquence élevée et un faible coût technique ne rendent pas acceptable l’exposition de données très sensibles. Une excellente stabilité ne suffit pas si une erreur peut affecter gravement une personne sans recours possible.
Nous utilisons donc la grille pour orienter le mode d’usage.
Assister
Tâche variable ou erreur lourde de conséquences
L’IA recherche, résume, compare ou prépare. L’humain conserve la décision et l’action.
Exécuter, puis faire valider
Résultat facile à vérifier avant toute conséquence
L’IA réalise la tâche, puis demande une validation systématique.
Automatiser sous surveillance
Processus stable, erreurs détectables, actions réversibles
Une automatisation devient envisageable. Elle reste bornée, journalisée et interruptible.
Hors périmètre
Données trop sensibles, conséquences trop fortes, fonctionnement instable ou économie trop faible
Au moins temporairement. Renoncer à une mauvaise automatisation est aussi une décision de transformation.
Trois exemples pour voir la différence
Exemple 1 · Automatiser sous surveillance
Classer les pièces jointes d’une boîte générique
La tâche revient souvent, les catégories sont connues et une erreur de classement peut être corrigée. L’IA peut commencer par proposer la destination, puis déplacer automatiquement les documents lorsque sa fiabilité a été mesurée. Les cas incertains restent dans une file de vérification.
Exemple 2 · Exécuter, puis faire valider
Répondre à une réclamation
L’IA peut retrouver l’historique, résumer le problème et préparer un message cohérent avec les règles de l’entreprise. Elle fait gagner du temps sans prendre la responsabilité de la relation. La validation humaine reste logique, surtout si le message contient un engagement, une remise ou une reconnaissance de responsabilité.
Exemple 3 · Assister, ou renoncer
Prendre une décision de refus
Candidature, crédit, aide, remboursement important ou accès à un service. Même si l’IA sait analyser le dossier, les conséquences pour la personne, le besoin d’explication et le risque de biais imposent un niveau de contrôle beaucoup plus élevé. Dans certains contextes, l’IA pourra préparer l’analyse sans décider. Dans d’autres, son usage ne sera simplement pas approprié.
La technologie peut être identique dans les trois cas. Le bon niveau d’autonomie ne l’est pas.
Commencer par un pilote qui n’agit pas
Le meilleur premier test est souvent un dispositif qui ne produit encore aucune conséquence réelle.
On commence par observer la manière dont la tâche est réalisée aujourd’hui. Combien de temps prend-elle ? Quels sont les cas fréquents ? Où apparaissent les erreurs ? Quels critères les professionnels utilisent-ils, parfois sans les avoir formalisés ?
L’IA travaille ensuite sur des cas passés ou en parallèle de l’équipe. Elle propose un classement, une réponse ou une action, mais ne l’exécute pas. On compare ses résultats avec le travail humain.
Cette phase permet de mesurer la qualité, le temps réellement gagné, les exceptions et le coût par tâche réussie. Elle révèle aussi des problèmes que la démonstration ne montre jamais : données manquantes, consignes contradictoires, vocabulaire métier ambigu ou règle connue d’une seule personne.
Lorsque les résultats sont satisfaisants, les droits peuvent être ouverts progressivement. Lecture de nouvelles sources, création d’un brouillon, écriture dans un espace de test, puis actions limitées et réversibles. Chaque étape doit avoir ses seuils d’arrêt et sa procédure de reprise manuelle.
Cette prudence n’est pas un frein à l’innovation. Elle permet d’aller plus loin sans jouer la réputation de l’organisation sur un coup de dé.
Choisir l’autonomie plutôt que subir l’outil
Les agents IA vont rendre beaucoup d’automatisations plus simples à construire. Des logiciels savent déjà lire des documents, naviguer dans des interfaces, utiliser plusieurs applications et enchaîner des actions avec une intervention humaine réduite.
La disponibilité de cette puissance ne dit rien de la manière dont elle doit être utilisée.
Une organisation sérieuse ne demande pas seulement si l’IA peut réaliser une tâche. Elle examine sa fréquence, sa stabilité, les données nécessaires, les conséquences d’une erreur, la qualité du contrôle humain et le coût complet du résultat.
Ce travail paraît moins séduisant qu’une démonstration spectaculaire. C’est pourtant là que se joue la différence entre un gadget, une prise de risque mal évaluée et une transformation qui améliore réellement le travail.
Un processus devient automatisable lorsque l’organisation sait aussi détecter l’erreur, l’arrêter et reprendre la main.
L’article en une image
Sources
- The Anthropic Economic Index · Anthropic
- Robotic process automation criteria: Exploratory studies · e-mentor
- AI Risk Management Framework 1.0 · NIST
- Règlement (UE) 2024/1689, article 14 · EUR-Lex